Caderno Basicx / Moda e recomendação
Motor de recomendação de moda:
o LLM propõe, o motor garante.
Como transformar o método de uma especialista em recomendações com peças reais, regras verificáveis e espaço para dizer “não sei”.
O que este projeto mostra
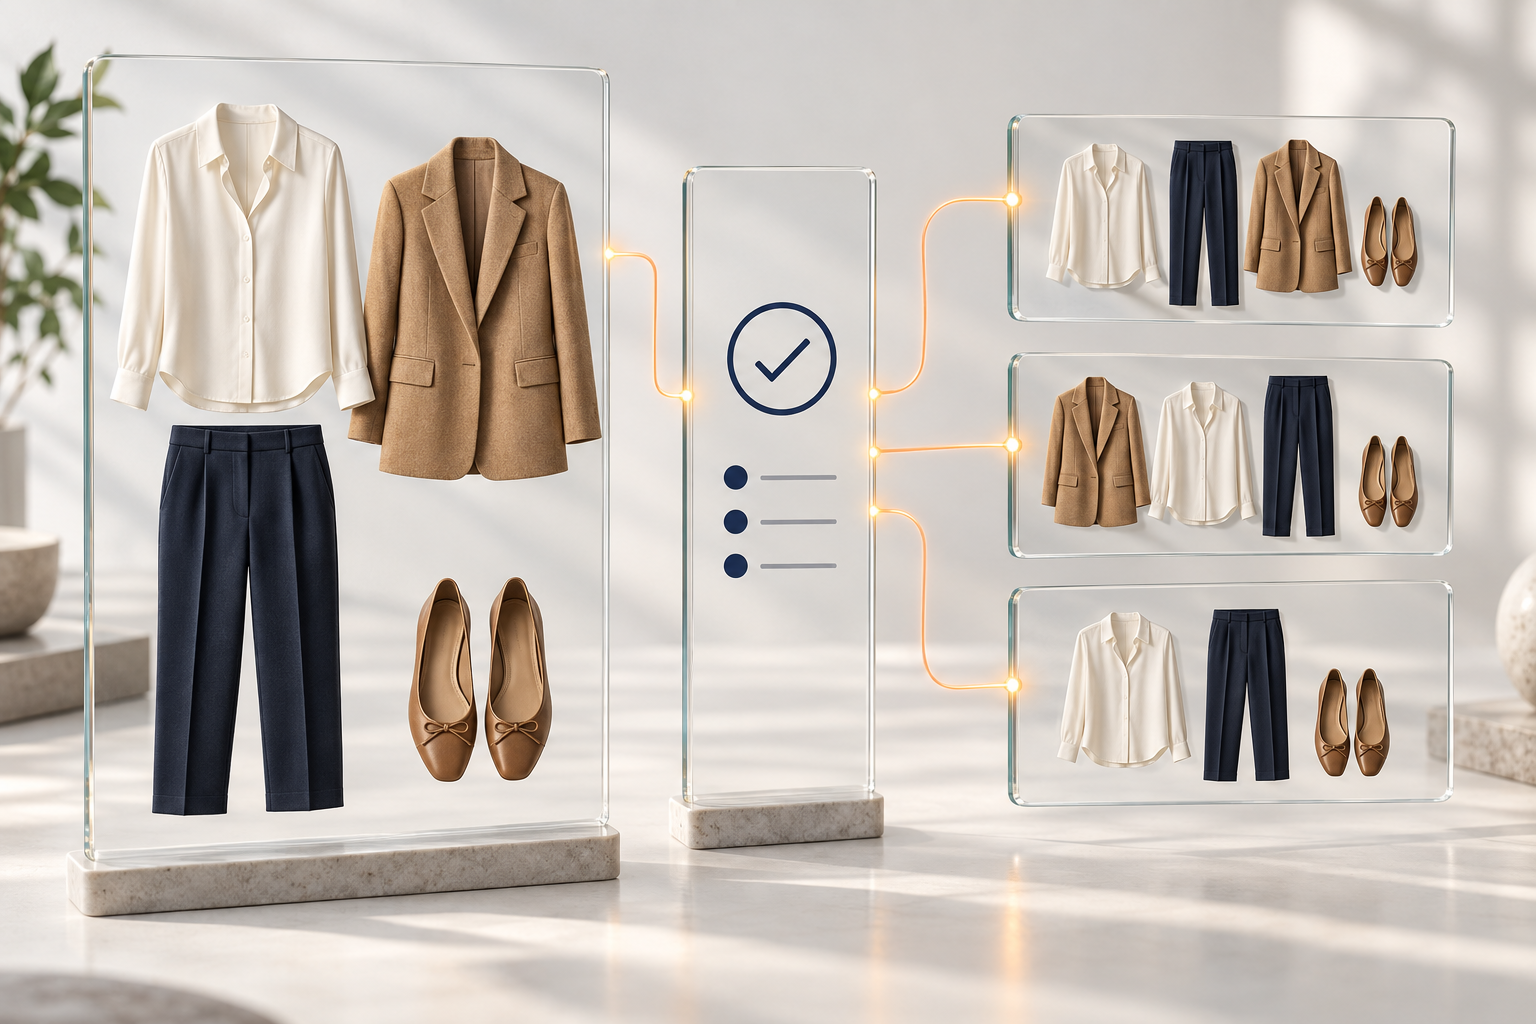
- O modelo propõe cinco candidatos; regras e validações selecionam três looks com peças do closet real.
- Os resultados são medidos em testes do projeto. Passar nos gates não equivale a comprovar a qualidade em produção.
- O julgamento de ocasião com Jev está atrás de uma flag, desligada por padrão.
O problema: "com o que eu uso isso?"
Recomendar moda não é prever o próximo clique. É responder uma pergunta que nenhum widget de e-commerce responde: o que funciona junto, para esta pessoa, nesta ocasião — e por quê.
O recomendador clássico de varejo responde outra pergunta: "quem levou A também levou B". Isso é estatística de carrinho. Ela não sabe o que é um look, não conhece "reunião com cliente" e regride ao gosto médio. Também exige histórico, que um cliente novo não tem.
Neste projeto, o ponto de partida foi diferente: um método de consultoria de imagem já existente, criado por uma consultora especializada. A meta não era aprender gosto com cliques. Era codificar o critério de uma especialista e fazê-lo escalar a cerca de US$ 0,05 por recomendação.
Este artigo conta como o motor foi construído, como ele é avaliado e o que os números mostraram — inclusive onde eles contrariaram a intuição.
Arquitetura: o LLM propõe, o motor garante
A regra que organiza tudo: o modelo de linguagem é trocável; a garantia do método fica nas camadas determinísticas. O primeiro experimento mostrou o LLM sozinho errando o básico — inventando peça, formalizando por padrão. Por isso ele nunca tem a última palavra.
Uma recomendação passa por cinco etapas:
- Recuperação. Busca no corpus de 147 looks validados os exemplos mais próximos do registro da ocasião (íntimo, social, profissional ou festa). O retrieval é lexical e estruturado, com MMR para variar os exemplos.
- Proposta. O LLM recebe o guia do método, os exemplos e o closet da cliente. Devolve um pool de 5 candidatos com peças-âncora variadas.
- Normalização. Código puro ancora cada peça no closet real, pontua os candidatos com 12 features derivadas das regras do método e seleciona 3 looks distintos.
- Guards. Regras de veto têm a última palavra: tecido × ocasião, cor de calçado, combinações reprovadas pela especialista, lacuna que sugere peça que a cliente já tem.
- Pós-validação. Checa invariantes da saída final. Se um guard alterou o look, a justificativa antiga é apagada em vez de mentir.
Só a etapa 2 depende do modelo de linguagem; as três seguintes podem alterar ou vetar o que ele propôs.
A saída é um look com ocasião nomeada, uma linha explicando por que funciona e, quando o acervo não fecha, uma recusa honesta com a peça específica que falta.
O que ficou de fora, com número
Duas apostas óbvias perderam na medição:
- Embeddings de moda no retrieval. FashionCLIP acertou o registro da ocasião em 65% dos casos; o retrieval lexical e estruturado, em 98%. O espaço visual não conhece "reunião com cliente".
- Modelo de compatibilidade treinado em Polyvore. Ficou em ~56% no teste de completar o look. Regras derivadas das avaliações da especialista foram melhores, porque codificam um método e não o gosto médio de rede social.
A escolha do LLM virou decisão de preço, não de arquitetura. Com a camada determinística, Claude Sonnet 4.5, Claude Haiku 4.5, GPT-5-mini e até um Qwen 9B local passaram em 100% dos gates. O Haiku fez o mesmo com custo 66% menor e latência 46% menor.
Como avaliar um motor que não tem clique para otimizar
Sem histórico de cliques, a fonte de verdade é o olho da especialista. A primeira rodada de avaliação cobriu 24 células (closet × ocasião) e 42 looks. Dela saíram as regras de veto: nenhuma entra sem 0 falso-positivo contra as avaliações dela e ratificação na rodada seguinte.
O juiz não é um LLM
Testamos um LLM-juiz com exemplos. Ele concordou com a especialista em 72% a 76% dos vereditos — abaixo da linha de base ingênua de "aprovar tudo" no voto por look, e sistematicamente mais severo que ela. Foi estacionado.
No lugar, um juiz determinístico conta padrões-problema conhecidos em cada saída. É menos ambicioso e muito mais útil: estável, auditável e barato de rodar a cada mudança. Os padrões reprovados na primeira rodada estão zerados desde a segunda.
Um eval em camadas
| Camada | O que mede | Barra |
|---|---|---|
| L0 contrato | peças existem no closet, 3 looks distintos, sem jargão | 100% / 0% |
| L1 regras duras | violações de veto, por um detector independente dos guards | 0 |
| L2 padrões reprovados | combinações que a especialista recusou | 0 |
| L2b honestidade | recusa só quando o closet de fato não cobre | 100% |
O detector da L1 é separado dos guards de propósito. Um guard que se auto-avalia sempre passa.
Onde o eval ainda engana
100% no gate não é qualidade. Os limites que conhecemos:
- Gold circular. Uma anotadora, uma rodada, e os mesmos looks geraram e validaram as regras.
- Uma execução por célula num motor estocástico. Algumas células oscilam entre execuções.
- Testes no motor errado. A maior parte de uma suíte de ~980 testes verdes cobria o motor legado, não o caminho que a usuária vê.
Julgar a ocasião com o Jev
Antes de chamar o LLM, o motor precisa saber em que registro cai a ocasião. Esse registro muda os exemplos recuperados e liga ou desliga o guard contra sobre-formalização. Até aqui, uma tabela de palavras-chave decidia.
A tabela falha de dois jeitos previsíveis. Não devolve nada quando a ocasião não tem palavra da lista ("show de rock", "day off"). E classifica pela palavra errada: "happy hour com colegas depois do trabalho" vira profissional por causa de "trabalho".
Por que um modelo de julgamento, e não mais um prompt
O Jev, da TypeSafe, é um modelo de julgamento tipado. Recebe um estado em JSON e perguntas com critérios escritos. Devolve uma escolha, a distribuição de probabilidade e a confiança — e não gera texto. O código consome a resposta direto, sem parsing.
Cada recomendação faz uma chamada com duas perguntas, nos eixos do próprio método:
- Onde: casa ou lazer, espaço social, trabalho híbrido, trabalho formal, evento ou cerimônia — ou "não dá para saber".
- Diante de quem: só íntimos, gente que vê, quem avalia — ou "não dá para saber". O eixo mede exposição, não companhia: família num restaurante ainda é gente que vê.
Uma regra fechada, em código, combina os dois eixos no registro. Trabalho ou alguém que avalia dá profissional; evento dá festa; os dois eixos em aberto dão ambíguo.
O que mediu
Na primeira rodada, com 51 ocasiões rotuladas por uma pessoa, o Jev acertou 92,2% do registro e a tabela, 74,5%. Um segundo revisor reavaliou os casos e endureceu os rótulos. Contra esse gold, a versão em dois eixos marcou 74,5% e a tabela, 58,8%. O número absoluto caiu; a vantagem de ~16 pontos ficou.
Nos casos em que o revisor foi claro, o Jev acertou 87% no eixo "onde" e 93% no "diante de quem". Deu a mesma resposta nas 3 execuções em 50 de 51 casos. O erro mais comum é o oposto do da tabela: onde o revisor disse "não dá para saber", o Jev tende a supor um espaço social.
As 153 chamadas do teste custaram US$ 0,005, a ~0,3 s cada. Com o Jev ligado, os evals de cobertura e de cold start rodaram 3 vezes em cada modo, sem queda: groundedness e recusa correta seguiram em 100%.
Como entrou no motor
- Um eixo que o app já informou nunca é sobrescrito.
- Nos demais, vale o Jev; eixo com confiança abaixo de 0,5 vira "não dá para saber".
- Erro, timeout de 2 s ou falta de chave caem na tabela antiga. O julgamento nunca derruba a recomendação.
O eixo em aberto é o ganho que a tabela não tinha. "Jantar" sozinho sai como ambíguo, e o app pode perguntar à cliente só o que falta — onde vai ser, com quem — em vez de gerar no chute.
A integração está atrás de uma flag, desligada por padrão. O próximo teste usa 30 a 50 ocasiões reais, anonimizadas; é ele que decide se a flag vira padrão.
O que o Jev não faz
- Não monta look. Não escolhe peça nem substitui guard; as regras validadas ficam em código.
- Não substituiu tudo que testou. Para classificar atividade física, deu empate com a tabela (90% × 94%), e a tabela ficou.
- Não dispensa disciplina. O texto do critério é código. Exemplos que coincidiam com o teste inflaram o acerto de 92% para 96%; os critérios em uso não têm nenhum.
Telemetria: medir o que a seleção não mostra
O seletor MMR equilibra relevância e diversidade para escolher 3 looks do pool de 5. Uma revisão externa do motor levantou duas perguntas que a telemetria não respondia.
- E se a relevância vira constante? Se o LLM dá notas quase iguais a todos os candidatos, o termo de relevância do MMR some. A seleção degenera em diversidade pura, sem ninguém perceber. Agora cada recomendação registra média, desvio e amplitude da relevância do pool. Se o desvio ficar perto de zero no tráfego real, o plano é trocar notas por posições antes do MMR.
- E se os guards colapsam a variedade? Um guard pode trocar a mesma peça em dois looks e torná-los iguais. Esse colapso acontecia depois da seleção e era invisível. Agora é marcado na telemetria de cada recomendação.
O padrão vale para além deste caso: antes de mexer no algoritmo, instrumentar a pergunta. Um A/B de 24 células entre MMR e DPP deu diversidade 0,826 × 0,838 — dentro do ruído. Com um pool de 5, o seletor mais sofisticado não tem espaço para brilhar. O MMR ficou.
O retrieval passou pelo mesmo crivo. Num teste offline com 61 looks, sem LLM, cada look buscou a si mesmo: recall@8 de 1,0 e MRR de 0,958. Os pesos estão saudáveis, e o teste roda de novo a cada mudança de corpus.
Onde isso se encaixa no mercado
O motor não substitui o recomendador de um e-commerce. Ele ocupa um momento que nenhum widget ocupa: "eu levo, mas com o que eu uso isso?" — a dúvida que trava compra de ticket alto.
| Família | Como decide | Limite | O que muda aqui |
|---|---|---|---|
| Filtro colaborativo | correlação de compra | sem ocasião, sem porquê, exige histórico | critério codificado; funciona com 5 perguntas de perfil |
| Similaridade visual | proximidade no espaço de imagem | parecido não é combina | 98% × 65% no acerto de registro |
| Complete-the-look | co-ocorrência editorial | genérico, ignora o que a pessoa já tem | closet real primeiro, catálogo em complemento |
| Compatibilidade treinada | gosto médio de outfits de rede social | codifica a média, não um método | regras da especialista superaram o scorer |
| LLM-stylist | o modelo "acha" | alucina peça, não garante nada | groundedness 100% medido |
| Stylist humano | especialista real | caro, lento, não escala | ~US$ 0,05 por recomendação |
Dois traços nenhuma dessas famílias tem:
- Recusa honesta. Todo recomendador empurra algo; o incentivo é encher a vitrine. Este recusa quando o closet não fecha e diz qual peça falta. A especialista aceitou 8 de 8 recusas na validação. Somadas, as recusas viram um mapa do que falta no sortimento.
- Explicação auditável. Cada decisão tem trilha: qual regra agiu, de onde ela veio e o que mudou no look.
O que os incumbentes fazem melhor também precisa ser dito: personalização comportamental em escala massiva e busca visual. Isso exige volume de cliques que um produto novo não tem.
Lições e próximos passos
Cinco lições valem para qualquer motor de recomendação construído sobre um LLM:
- Deixe o LLM propor e o código decidir. A camada determinística tornou o modelo trocável. A escolha de LLM virou uma conta de custo com gate de qualidade.
- Meça antes de adotar a técnica da moda. Embeddings, DPP e modelos treinados perderam ou empataram com soluções mais simples, no tamanho de corpus que temos.
- Use um juiz que você consegue auditar. Um contador determinístico de padrões reprovados foi mais útil que um LLM-juiz com 72% de concordância.
- Cada regra pontual sem eval é uma regressão esperando. Diretrizes "filosóficas" adicionadas ao prompt reintroduziram sobre-formalização; só o eval de cold start pegou.
- Saber recusar é produto. A recusa honesta foi o traço mais bem avaliado pela especialista e o que nenhum concorrente quer copiar.
Os próximos passos, em ordem:
- Extração visual das peças com um modelo de visão (Qwen3-VL). Destrava 72% das 163 regras do método, que hoje dependem de atributos que o cadastro não preenche.
- Feedback de uso (gostei, não gostei, usei) voltando para o eval e para o gold. É o que fecha o ciclo de personalização.
- Segunda rodada da especialista sobre o motor de produção, que decide a troca para o Haiku.
- Um A/B de arquitetura: o LLM propõe × o motor propõe e o LLM só explica. Quando a extração visual chegar, essa é a decisão mais importante do roadmap.
Termos usados neste artigo
- LLM
- Modelo de linguagem que gera as propostas de looks.
- Guards e gates
- Guards vetam saídas que violam regras. Gates são critérios de aprovação nos testes.
- Gold
- Conjunto de avaliações usado como referência para comparar resultados.
- MMR e DPP
- Abordagens para selecionar opções considerando relevância e diversidade.
- Groundedness
- Verificação de que as peças recomendadas existem no acervo fornecido.
- Flag
- Configuração que permite habilitar ou desabilitar uma funcionalidade.
Da regra à aplicação
Seu método pode fazer parte da solução.
Converse sobre recomendações construídas com o conhecimento da sua operação.
Conheça a solução de recomendação