Caderno Basicx / 03 / Matching cliente–imóvel
Matching cliente–imóvel: primeiro, parar de errar
Como a CF Intelligence reconstruiu o motor que cruza perfis de clientes com o acervo, e por que medimos "não errar" antes de medir "acertar o melhor".
O problema
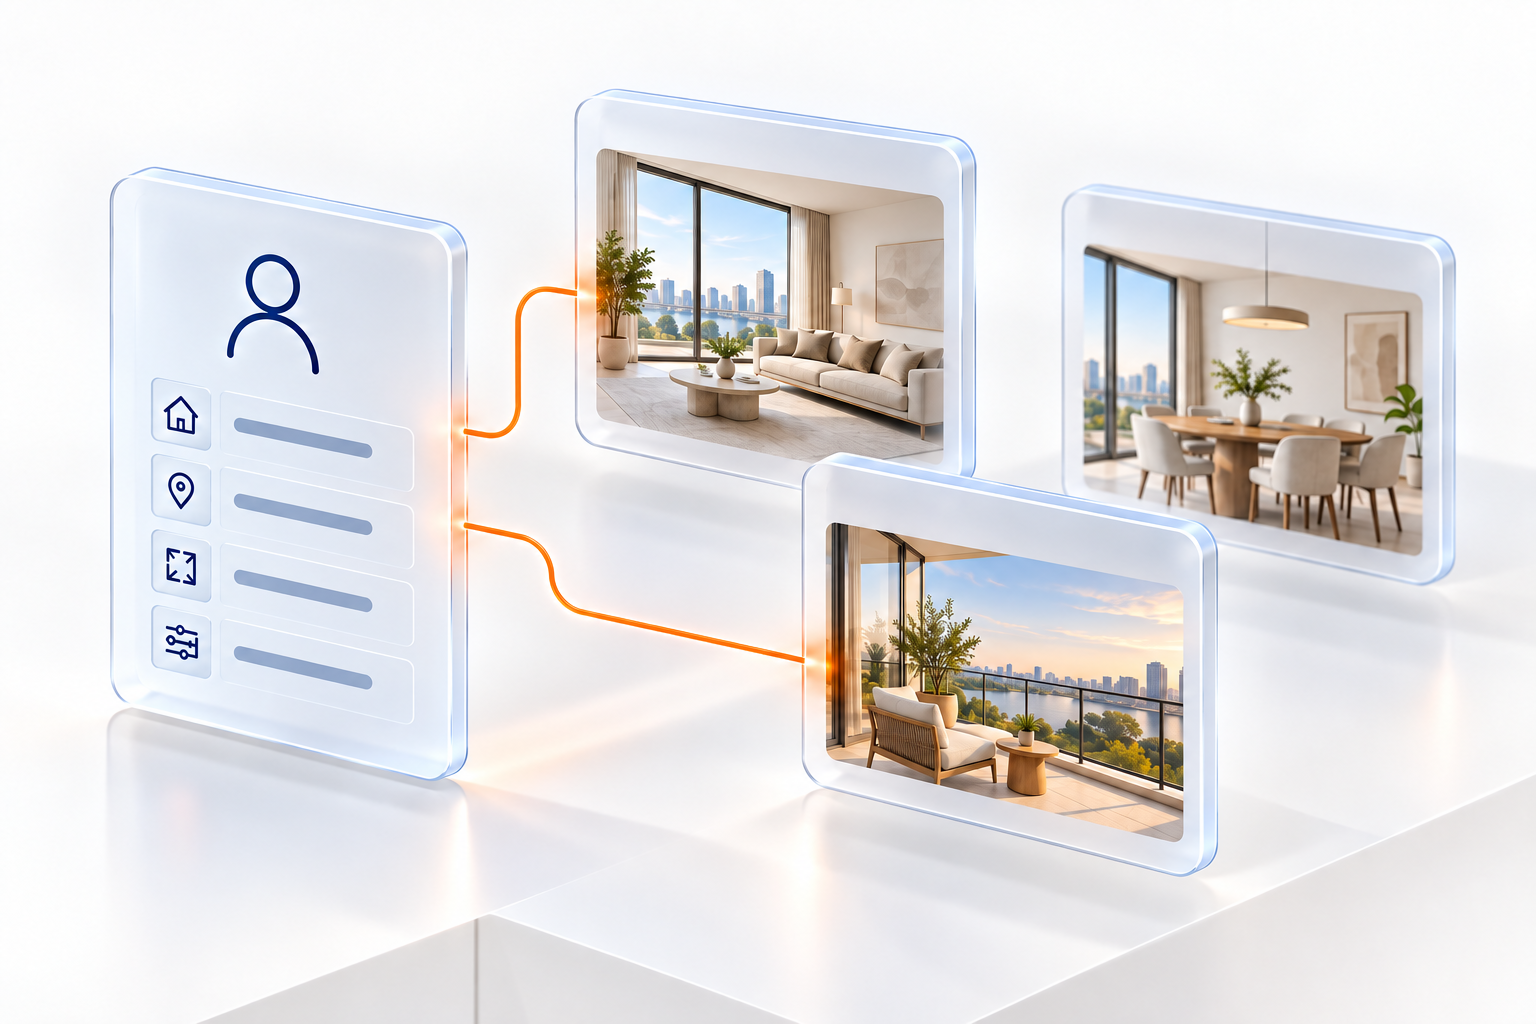
A busca responde a uma pergunta pontual do corretor. O matching faz outra coisa: cruza o perfil completo de um cliente com o acervo inteiro e propõe imóveis.
Esse perfil, o briefing, mistura muita coisa:
- coisas que o cliente disse;
- coisas que o corretor percebeu;
- restrições firmes;
- desejos vagos.
O acervo, por sua vez, tem informação incompleta: uma parte relevante dos atributos de qualquer imóvel é, honestamente, "desconhecida".
Um matching ruim falha de dois jeitos:
- por excesso: propõe imóveis fora do bairro, acima do teto ou com aquilo que o cliente disse que não quer. O corretor perde a confiança na primeira lista;
- por falta: veta imóveis bons só porque falta uma informação. O cliente nunca vê o imóvel certo.
Princípios do motor
Dois passos, com responsabilidades separadas
- Veto simbólico. Um imóvel só é excluído quando há evidência de que ele viola uma exigência do cliente: ausência comprovada, preço acima do teto ou localização fora da área. "Desconhecido" nunca veta.
- Pontuação ponderada. Os imóveis que sobram são ordenados pelo quanto atendem às preferências, com pesos por eixo: localização, tipologia, atributos e estado.
Uma autoridade única
Briefing, busca e matching usam o mesmo núcleo de regras, publicado como pacote versionado e com contratos explícitos de entrada e saída. Antes, partes da lógica estavam duplicadas entre serviços, e uma correção em um lugar não chegava ao outro. Hoje não há caminho alternativo: se o núcleo não responde, o sistema diz isso em vez de improvisar.
Vazio honesto e relaxamento controlado
Quando o acervo não tem nada que atenda ao briefing inteiro, o motor relaxa critérios numa ordem definida e avisa quais critérios relaxou. Se nem assim encontra nada, devolve uma lista vazia com a explicação. Uma lista cheia de imóveis errados é pior que uma lista vazia.
Os resultados
Briefings de clientes: menos imóveis errados
Para não avaliar o motor só com os casos que motivaram as correções, um gerador independente, sem acesso aos defeitos conhecidos, produziu 20 briefings de clientes sintéticos. Um briefing conta como "limpo" quando nenhum imóvel proposto viola uma exigência sem aviso.
| Indicador | Antes | Depois |
|---|---|---|
| Briefings limpos | 13/20 | 17/20 |
Menos violações do briefing.
Briefings limpos em 20 perfis sintéticos · maior é melhor.
Fonte: artigo 3, gerador independente de 20 briefings sintéticos. “Limpo” = nenhum imóvel proposto viola uma exigência sem aviso. O teste não comprova a melhor ordenação.
Localização: o bairro passou a valer
Num caso de produção, o motor ignorava o bairro pedido quando relaxava outros critérios: o universo de candidatos era o acervo inteiro da faixa de preço. Depois da correção, medida em dois clientes reais:
| Indicador | Antes | Depois |
|---|---|---|
| Universo de candidatos | 2.268 (bairro ignorado) | 545 e 1.142 |
| Primeiros 100 no bairro pedido | não garantido | 100% |
Negação: "não quero piscina" passou a ser respeitado
Em testes com perfis que rejeitam um atributo, por exemplo um cliente avesso a piscina:
| Indicador | Antes | Depois |
|---|---|---|
| Imóveis vetados que ainda eram propostos | 10 de 10 | 0 |
O motor passou a distinguir os imóveis
Num cliente real, todos os 10 primeiros imóveis recebiam a mesma nota (93,75). Na prática, a ordem era arbitrária. Depois da reforma do cálculo, os 10 primeiros passaram a ter 9 notas distintas. O motor voltou a dizer qual imóvel atende melhor.
Bateria de regressão
Mantemos uma bateria de critérios de aprovação ("gates") que toda versão precisa passar antes de ir para produção:
- discriminação da nota;
- respeito a negações;
- 48 invariantes lógicos;
- 22 casos canônicos.
A versão em produção passou de 3 para 7 de 7 gates.
Numa bateria julgada por um especialista humano, a precisão nos 5 primeiros resultados chegou a 69%, contra uma meta de 60%. Sem a fatia mais difícil, ela chega a 84%.
Essa fatia mais difícil é feita de consultas adversariais. Elas pedem algo que a base ainda não registra, como um teto de condomínio para imóveis sem o valor do condomínio cadastrado. Nela, o resultado é de 15%.
Nesses casos o motor não inventa uma resposta. Quando uma exigência não pode ser verificada em nenhum resultado, ele avisa isso com destaque. A solução de fundo é completar os dados, e não mexer no algoritmo.
Desempenho
Uma reescrita do componente de comparação textual por índice invertido deixou esse passo 2,25× mais rápido, com zero divergência de resultado em 2.465 comparações.
Como medimos
- Gabaritos congelados antes de rodar. O gabarito de cada teste é escrito e registrado com hash criptográfico antes de qualquer versão ser executada. Ninguém ajusta o critério depois de ver o resultado.
- Clientes sintéticos gerados de forma independente. As correções foram desenhadas sobre um conjunto de casos, e a avaliação usa outro, gerado sem acesso aos defeitos. Um resultado de 30 em 30 nos casos que motivaram as correções não conta como evidência, e nós não o usamos como tal.
- Votos de corretores. Uma vitrine em que corretores avaliam imóveis propostos para clientes reais é a régua final.
- Juízes automáticos só como proxy. Medimos a concordância de cada juiz automático com o corretor antes de usá-lo. Um dos modelos avaliados ficou abaixo do acaso e foi descartado.
O que ainda não está resolvido
Este é o artigo da série em que mais importa ser preciso sobre o que foi provado.
Provamos que o motor parou de propor imóveis errados. Ainda não provamos que ele ordena os certos na melhor ordem.
- Ordenação. Num caso real, dois imóveis aprovados pelo corretor caíram das posições 6 e 9 para além da 270ª depois de uma correção. A causa é conhecida: quando vários imóveis empatam nos fatos, quem desempata é a similaridade de texto, e o texto do anúncio não reflete o que o cliente valoriza. A correção está em andamento, e é exatamente o tipo de regressão que a bateria existe para pegar.
- Reordenação por modelos. Testamos reordenar a lista com um modelo de linguagem. O ganho médio foi positivo, mas com intervalo de confiança cruzando zero em uma amostra de 5 clientes. Não fomos para produção com um ganho que não conseguimos distinguir de ruído.
- Tempo de resposta. Reativar o sinal semântico no matching subiu o tempo mediano de cerca de 6 s para cerca de 10 s. A otimização está mapeada: boa parte do tempo vai para consultas de banco sem índice.
- Qualidade dos dados. O matching só é tão bom quanto as fichas. Hoje, mais da metade dos atributos do acervo está como "desconhecido", e o motor trata isso de forma neutra, sem premiar nem punir. Aumentar a cobertura de atributos (veja o primeiro artigo) é a alavanca de maior impacto no matching.
O próximo passo de avaliação
O próximo passo é uma rodada comparativa cega de ordenação, desenhada antes de rodar:
- pelo menos 36 votos;
- dois corretores avaliando de forma independente;
- critério de aprovação pelo limite inferior do intervalo de Wilson, e não pela média.
Por que isso importa
Em recomendação, a tentação é otimizar uma métrica de ranking e anunciar o número. Nós escolhemos outra ordem:
- Garantir que o sistema nunca proponha o que o cliente recusou.
- Garantir que ele diga o que relaxou quando não há resposta perfeita.
- Só então otimizar a ordem, com votos humanos e critérios fixados antes.
Os dois primeiros itens estão medidos e em produção. O terceiro está em curso, e vamos relatá-lo com a mesma régua.
Artigos da série: extração de atributos, busca semântica e matching cliente–imóvel.