Caderno Basicx / 02 / Busca semântica
Busca em linguagem natural para imóveis: por que embeddings sozinhos não bastam
O que aprendemos construindo a busca semântica da CF Intelligence, e por que a maior parte do ganho não veio de onde esperávamos.
O problema
Um corretor de alto padrão não preenche formulário. Ele digita o que o cliente disse:
"Apartamento nos Jardins, 3 suítes, até 8 milhões, sem piscina, de preferência reformado."
Essa frase mistura quatro tipos de pedido:
- restrições duras: bairro, número de suítes e teto de preço;
- uma negação: sem piscina;
- uma preferência: de preferência reformado;
- vocabulário local: "Jardins" não é um bairro oficial, mas uma região que todo paulistano reconhece.
A resposta padrão do mercado em 2026 é usar embeddings, ou seja, transformar a frase e os anúncios em vetores e devolver os mais parecidos. Nós começamos por aí. Este artigo conta o que os números mostraram depois.
A arquitetura atual
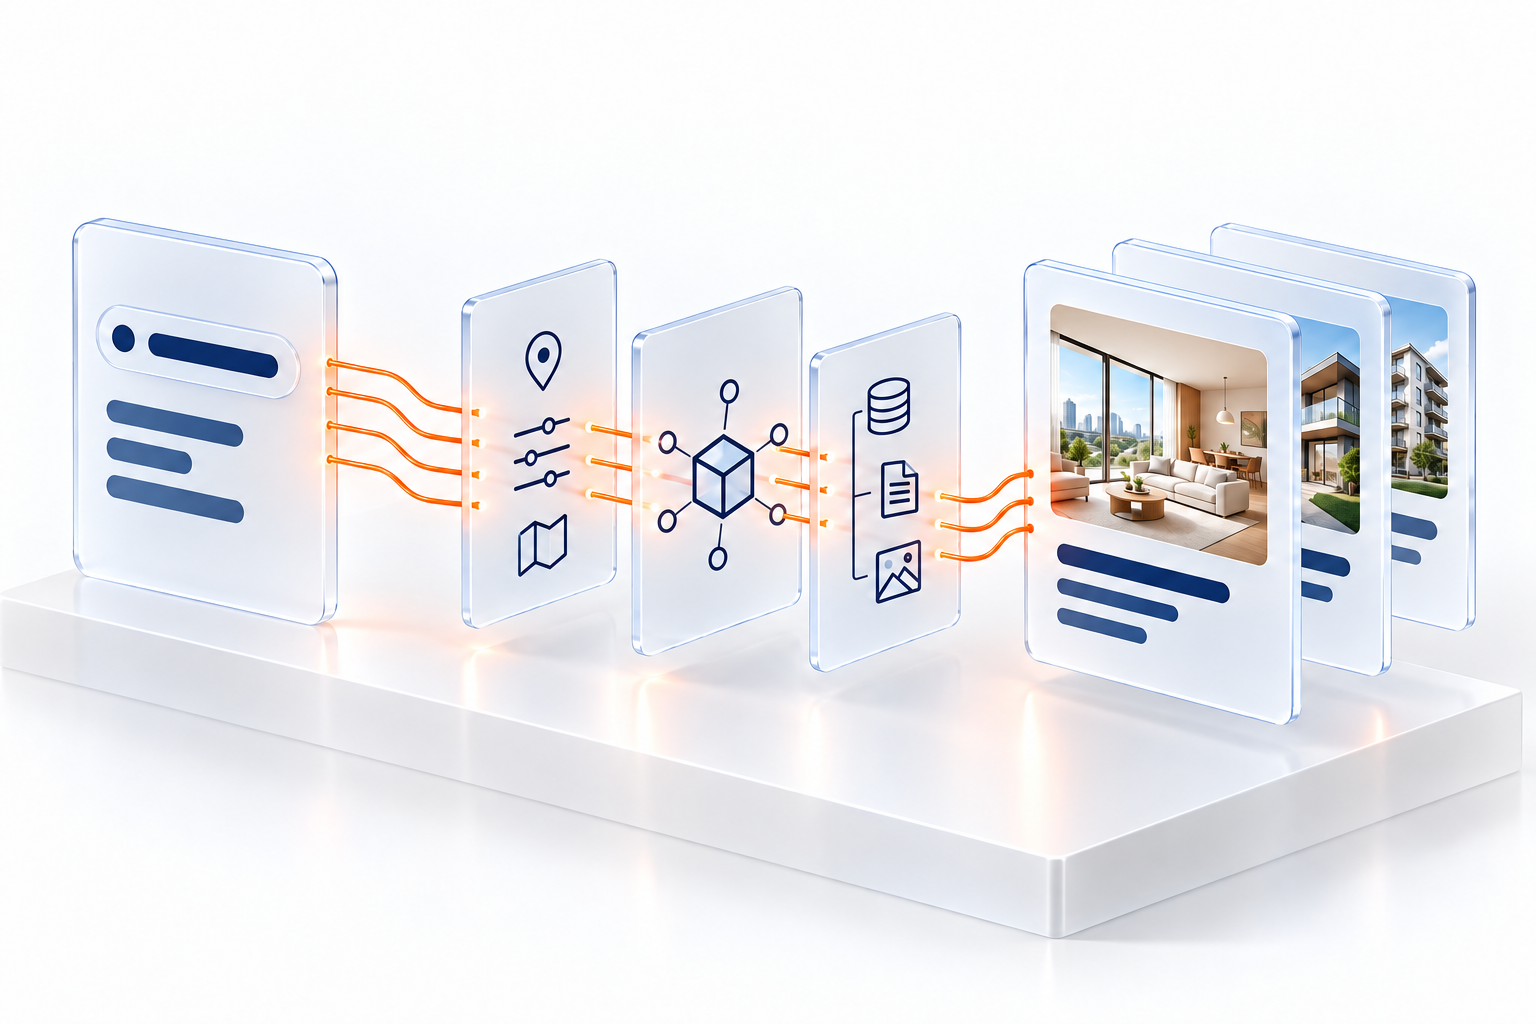
A busca tem três camadas. Cada uma tem uma responsabilidade clara.
1. Interpretar antes de buscar
Um modelo de linguagem lê o pedido e preenche um menu fechado. Ele não escreve texto livre, porque a saída precisa ser auditável. O menu separa:
- filtros, aquilo que o cliente exige;
- preferências, aquilo que o cliente gostaria de ter;
- negações, que viram veto explícito;
- o que ficou fora do menu.
Quando o núcleo do pedido não pode ser atendido, o sistema devolve um "vazio honesto" com a explicação, em vez de devolver qualquer coisa.
2. Gerar candidatos por quatro caminhos em paralelo
Quatro geradores rodam ao mesmo tempo:
- atributos estruturados do imóvel, extraídos das fotos (veja o primeiro artigo da série);
- vetor semântico do pedido interpretado;
- vetor semântico do anúncio;
- busca lexical clássica (BM25).
As listas dos quatro são combinadas por fusão de ranking (Reciprocal Rank Fusion). Um princípio importante: os geradores só sugerem candidatos, nunca excluem imóveis. A exclusão é responsabilidade de uma única camada, com regras explícitas.
3. Vetar, depois ordenar
Os candidatos passam por um veto simbólico, que só remove um imóvel quando há evidência de que ele viola o pedido. Atributo desconhecido nunca veta.
Depois, os imóveis que restam são ordenados pela média ponderada das preferências atendidas. A similaridade semântica entra só como desempate. A próxima seção explica por quê.
Os resultados
Benchmark controlado: o que cada técnica faz bem
Primeiro, comparamos quatro abordagens no mesmo acervo de 330 imóveis, com 12 consultas divididas por tipo de dificuldade. A métrica é nDCG@10, que vai de 0 (inútil) a 1 (ordem perfeita).
| Tipo de consulta | Lexical (BM25) | Semântica (embeddings) | Fusão (RRF) | Fusão + reordenação por LLM |
|---|---|---|---|---|
| Média geral | 0,50 | 0,69 | 0,68 | 0,83 |
| Negação ("sem piscina") | 0,38 | 0,92 | 0,85 | 1,00 |
| Imóvel novo, pouca informação | 0,65 | 0,53 | 0,81 | 0,90 |
| Preço | 0,03 | 0,46 | 0,22 | 0,48 |
Três leituras:
- Embeddings ganham do lexical com folga em média, e especialmente em negação. É o resultado esperado.
- A fusão só compensa em imóveis com pouca informação. Na média, ela empata com a busca semântica pura.
- Nenhuma técnica de recuperação resolve preço. Mesmo o melhor braço fica em 0,48. Preço, metragem e número de suítes precisam de filtro estruturado, não de similaridade de texto. Esse resultado foi decisivo para a arquitetura.
Produção: buscas reais de corretores
Benchmarks controlados não bastam. Por isso pegamos 15 buscas reais, digitadas por corretores em produção, e escrevemos o gabarito de cada uma antes de rodar qualquer versão. Uma busca conta como "limpa" se nenhum dos 10 primeiros resultados viola o pedido sem avisar.
| Indicador | Versão inicial | Outubro, 1ª rodada | Outubro, 2ª rodada |
|---|---|---|---|
| Buscas limpas | 10/15 | 12/15 | 14/15 |
| Imóveis fora do pedido no top-10, sem aviso | 19 | 3 | 1 |
| Tempo de resposta (mediana) | ~16 s | 7,5 s | 8,3 s |
| Custo por busca | US$ 0,021 | US$ 0,021 | US$ 0,021 |
Mais buscas que respeitam o pedido.
Buscas limpas entre as mesmas 15 consultas reais · maior é melhor.
Fonte: artigo 2, avaliação em produção. “Limpa” = nenhum dos 10 primeiros imóveis viola o pedido sem aviso. Amostra pequena; a métrica não mede a qualidade da ordenação.
Os imóveis errados que chegavam ao corretor caíram de 19 para 1, e o tempo de resposta caiu pela metade.
Um defeito que só a observabilidade revelou
Numa bateria de produção em agosto, descobrimos que a camada semântica estava silenciosamente desligada. O tempo de cálculo do vetor da consulta era zero em 22 de 22 buscas, e a similaridade era zero em 592 de 592 resultados. Na mesma bateria, 4 de 22 consultas qualitativas devolviam o acervo inteiro, cerca de 16,5 mil imóveis.
Nada disso aparecia para o usuário como erro: a busca simplesmente funcionava pior. Hoje cada resposta registra o que cada camada contribuiu, e uma busca semântica indisponível nunca resulta em "devolver tudo".
A lição principal: o ganho veio da interpretação, não dos embeddings
Quando decompusemos a melhora de 10/15 para 14/15 nas buscas reais, ela veio principalmente de duas coisas:
- Interpretar melhor o pedido. Por exemplo, "acima de 5 milhões" é um piso, não uma faixa de um único valor. E um teto de preço que o cliente não disse não pode ser inventado.
- Conhecer o vocabulário do mercado. "Jardins" é uma região formada por vários bairros oficiais. Ensinar isso ao sistema zerou as violações em consultas sobre a região, inclusive em formas de escrever que não tínhamos visto antes.
Os embeddings são necessários, mas não foram o que separou uma busca boa de uma ruim.
Descobrimos também o contrário: similaridade semântica com peso alto faz mal. Numa análise com perfis de clientes, a similaridade de texto estava anticorrelacionada com o que o cliente queria: correlação de −0,26 entre o imóvel servido e o desejo declarado. Anúncios com texto parecido com o pedido não são necessariamente imóveis que atendem ao pedido. Por isso a similaridade virou desempate, com peso pequeno.
Experimentos que não foram para produção
- Reordenação por cross-encoder. Na CPU de produção, o tempo no percentil 95 era de 563 a 826 ms. Na bateria em produção, ele caiu no modo de segurança em 83% das chamadas, e o mecanismo automático de desligamento atuou. Está desativado.
- Reordenação por LLM. Foi o melhor resultado do benchmark (0,83), mas no teste com clientes o ganho foi de +0,003, com intervalo de confiança cruzando zero, ao custo de +2,4 s por busca. Não compensou.
- Agente autônomo. Um agente que lê o pedido e consulta o acervo por conta própria acertou 15 de 15 buscas reais, com 0 afirmações sem lastro em 373 verificadas. Mas custou cerca de 4× mais e levou cerca de 3× mais tempo. A versão híbrida foi a escolhida: o agente só entra quando a camada principal sinaliza algo que não resolveu, o que aconteceu em 2 de 15 buscas. Ela chega a 14/15 por US$ 0,032 por busca.
Limites que reconhecemos
- "Limpa" não quer dizer "ótima". A métrica de produção mede se a busca respeita o pedido, não se os primeiros resultados são os melhores possíveis. A avaliação de relevância por corretores, com votação cega, é a próxima etapa.
- Amostras pequenas. O benchmark tem 12 consultas e a avaliação de produção tem 15. Os intervalos de confiança são largos, e relatamos assim.
- Vocabulário em aberto. Apelidos como "Itaim" e referências como "perto da Faria Lima" ainda não são resolvidos pela camada principal. Hoje é o agente que os trata.
- Polaridade de estado. "Reformado" e "para reformar" ainda devolvem imóveis demais em comum. A causa está na extração: o estado de conservação é um dos atributos mais difíceis de ler em foto.
- Cobertura vetorial. Cerca de 82% do acervo tem vetor calculado. O restante é encontrado pelos outros três caminhos.
Por que isso importa
A busca semântica virou commodity: qualquer equipe consegue indexar anúncios num banco vetorial em uma tarde. O que separa um produto que o corretor usa de um que ele abandona é outra coisa:
- interpretar o pedido como o cliente quis dizer;
- nunca devolver um imóvel que viola o que foi pedido sem avisar;
- dizer "não encontrei" quando não há resposta boa.
Esses três comportamentos são mensuráveis, e foi neles que concentramos o trabalho.
Artigos da série: extração de atributos, busca semântica e matching cliente–imóvel.