Caderno Basicx / 01 / Extração de atributos
De 29 fotos a um atributo em que se pode confiar
Como a CF Intelligence extrai características de imóveis de alto padrão a partir de fotos e anúncios, e como medimos isso às cegas.
O problema
Quem procura um apartamento de alto padrão não pergunta só "três suítes nos Jardins". A pessoa pede uma cozinha integrada, uma varanda gourmet de verdade, piso de madeira e planta aberta. São essas características que separam um imóvel que interessa de um que só cabe nos filtros.
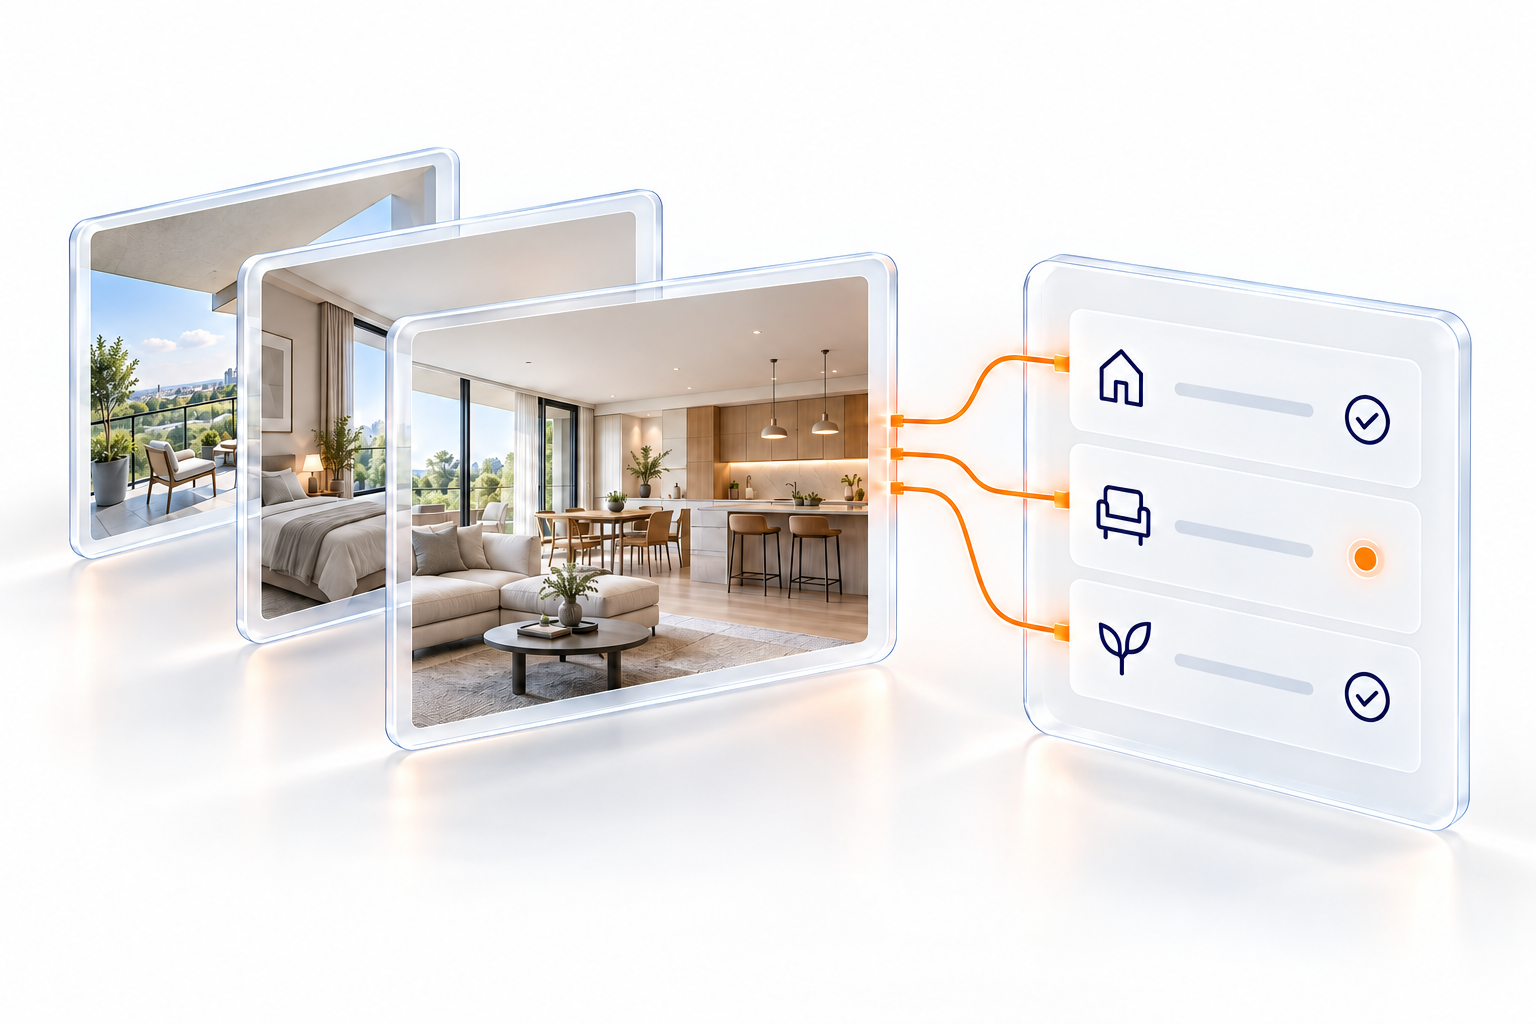
Elas quase nunca estão bem descritas. O anúncio médio tem texto genérico, campos estruturados incompletos e, em média, 29 fotos. A informação está nas fotos, mas ler 29 fotos de cada um de 16 mil imóveis é inviável para uma equipe humana.
Por isso a CF Intelligence usa modelos de visão para ler as fotos e o texto e transformar cada anúncio numa ficha estruturada. Isso hoje está ao alcance de qualquer equipe. A parte difícil é garantir que o que vai para a ficha seja verdade. Um atributo errado é pior que um atributo ausente: ele leva o corretor a mostrar o imóvel errado e corrói a confiança no sistema.
Este artigo descreve como construímos essa garantia e mostra os números.
Quatro decisões de projeto
1. Vocabulário fechado, com critérios escritos
O modelo não descreve livremente o imóvel. Ele escolhe entre cerca de 70 atributos, e cada um tem um critério de aceitação escrito com corretores. Um exemplo: "cozinha integrada" só conta quando uma única foto mostra a cozinha e a sala no mesmo ambiente. Um balcão visto de longe não basta.
Um vocabulário fechado pode ser auditado, comparado entre versões e usado por máquinas sem ambiguidade.
2. "Não sei" é uma resposta válida, e é a padrão
Cada atributo tem quatro estados possíveis:
- presente;
- ausente com evidência;
- desconhecido;
- não se aplica.
O estado padrão é desconhecido. O sistema nunca infere ausência pela falta de foto: se não há foto da varanda, isso não quer dizer que o imóvel não tenha varanda. Essa regra parece pequena, mas é ela que impede o sistema de vetar imóveis bons por falta de informação.
3. Um modelo barato em tudo e um modelo forte só quando precisa
Todo imóvel passa por um modelo de visão eficiente (Qwen3-VL). Um modelo mais caro e mais forte (Gemini 2.5 Pro) só é chamado quando há sinal de risco:
- contradição interna na ficha;
- confiança baixa;
- proveniência duvidosa das fotos.
Em produção, isso acontece em 20,6% dos imóveis.
4. Regras determinísticas e auditoria depois do modelo
A saída do modelo passa por dezesseis regras determinísticas. Elas fazem coisas como:
- usar a seção do anúncio de onde veio a foto;
- exigir um trecho do texto que comprove o atributo;
- reconciliar atributos incompatíveis entre si.
Depois disso, uma etapa de auditoria visual revisa os atributos mais propensos a erro.
Por fim, cada atributo tem uma regra de publicação própria: publica, audita ou segura para revisão humana. Um atributo difícil não bloqueia a ficha inteira; só ele espera.
Os resultados
O teste principal: um holdout cego e pré-registrado
O resultado mais importante vem de um experimento desenhado para não enganar a nós mesmos:
- 135 imóveis que o sistema nunca tinha visto;
- divididos em dois braços, um com a auditoria e outro sem;
- revisados por humanos que não sabiam a qual braço cada imóvel pertencia;
- critérios de sucesso registrados antes de olhar os resultados.
| Indicador | Sem auditoria | Com auditoria |
|---|---|---|
| Erro nos 10 atributos mais difíceis | 28,5% | 12,1% |
Menos erro nos atributos difíceis.
Taxa de erro nos 10 atributos mais difíceis · menor é melhor.
Fonte: artigo 1, teste principal. Holdout cego de 135 imóveis, dividido em dois braços. Critérios pré-registrados; avaliação humana. Escala de 0 a 30%.
A auditoria corta o erro em 58%. Isso é efeito causal, medido sem o avaliador saber o que estava avaliando.
Precisão do que chega ao corretor
Também medimos a precisão do que é efetivamente publicado, ou seja, do que o corretor vê:
| Rodada | Precisão de publicação |
|---|---|
| 42 imóveis novos | 93,5% |
| Conjunto adversarial, montado com os piores casos | 95% (19 de 20 atributos publicados), IC 95%: 76–99% |
| 10 imóveis novos, avaliação 100% cega | 100% (16/16), IC 95%: 81–100% |
A trajetória não foi uma linha reta. Ao longo de cinco rodadas, a precisão foi 93,5%, 91%, 75%, 80% e 100%. A rodada final só fechou depois que tiramos "vista" da publicação automática. Esse atributo exige um julgamento que nenhum modelo testado resolveu de forma confiável, e hoje ele passa por revisão humana.
O intervalo de confiança está na tabela de propósito. Com 16 atributos avaliados, "100%" quer dizer "pelo menos 81% com 95% de confiança". Esse é o tipo de número que relatamos.
Consistência entre o que o texto diz e o que as fotos mostram
O texto do anúncio é uma fonte independente das fotos. Por isso usamos a concordância entre as duas como sinal de qualidade:
| Versão | Concordância texto × visão | Amostra |
|---|---|---|
| v2 | 0,75 | piloto |
| v3.1 | 0,79 | piloto |
| Canário de produção | 0,83 | 432 imóveis |
No canário de 432 imóveis, houve zero casos em que o texto negava um atributo e a visão o afirmava. Essa é a contradição mais grave possível, e ela não apareceu.
Mais atributos, menos erros
Num A/B com 19 imóveis entre a versão anterior completa e a versão atual:
| Indicador | Antes | Depois |
|---|---|---|
| Falsos positivos | 12 | 8 (−33%) |
| Atributos úteis por imóvel | 9,2 | 12,8 (+39%) |
| Recall estimado | ~80% | ~85% |
Normalmente, ganhar riqueza significa ganhar erro junto. Aqui as duas coisas melhoraram ao mesmo tempo.
Custo
| Indicador | Custo |
|---|---|
| Modelo forte em 100% dos imóveis (40 imóveis) | US$ 2,73 |
| Modelo eficiente + forte condicional (mesmos 40) | US$ 1,13, ou seja, 2,4× mais barato |
| Produção, média por imóvel (901 imóveis medidos) | US$ 0,024 (mediana 0,011; p95 0,086) |
Dois centavos e meio de dólar por imóvel tornam viável reprocessar o acervo inteiro sempre que o vocabulário evolui. Isso muda o que se pode fazer com o produto.
Como medimos
A régua de tudo isso é o julgamento humano de corretores especialistas, não a opinião de outro modelo.
- Corpus de validação humana. Construímos uma ferramenta de revisão em que corretores marcam cada atributo como certo ou errado, foto a foto. Em poucas semanas, o corpus passou de 249 para 467 imóveis e mais de 3.300 correções.
- Teste de regressão gratuito. Um conjunto de 506 imóveis com 2.830 vereditos humanos roda contra toda versão nova, sem custo de LLM. Nenhuma versão vai para produção se piorar a precisão de um atributo já validado.
- Canários antes de cada escala. Antes de cada aumento de volume (50 → 500 → milhares), rodamos um canário com metas definidas antes: concordância, custo, taxa de escalonamento e contradições.
- Revisão cruzada. Rodadas importantes passam por um revisor independente, com erratas registradas.
O que não funcionou
Publicar o que deu errado faz parte do método. Algumas ideias promissoras que testamos e descartamos:
- Exemplos no prompt (few-shot). Os falsos positivos de "escritório" subiram de 42% para 67%.
- Rodar o modelo três vezes e votar. Custou o triplo e não melhorou a concordância (0,786 contra 0,780).
- Reescrever o prompt do zero. O modelo ficou conservador demais e quase parou de emitir atributos.
- Um verificador barato para substituir a auditoria. AUC de 0,79, abaixo do necessário.
- Uma versão de produção inteira. Foi descartada depois de detectada uma regressão no teste de regressão, antes de chegar ao corretor.
Limites que reconhecemos
- Os 100% de precisão vêm em parte de saber o que não publicar. Atributos como "cozinha integrada" e "paisagismo" continuam difíceis: em fotos de fronteira, a taxa de erro bruta passa de 50%. Esses atributos ficam com revisão humana em vez de serem publicados automaticamente. Escolhemos precisão sobre cobertura.
- Esse corte tem um custo em recall. Uma parte relevante dos atributos verdadeiros ainda não é publicada automaticamente. Aumentar a cobertura sem perder precisão é o próximo trabalho.
- O auditor automático é otimista. Em atributos perceptuais, ele aprova cerca de 20 pontos percentuais a mais do que o corretor humano. Por isso o humano continua sendo a régua, e não o auditor.
- Amostras humanas são caras. Vários resultados têm intervalos de confiança largos. Nós os relatamos assim, em vez de arredondar para cima.
Por que isso importa
A ficha estruturada é a base de tudo o que vem depois: a busca em linguagem natural e o matching entre clientes e imóveis só são tão bons quanto os atributos em que se apoiam. Um sistema que diz "não sei" quando não sabe, que publica só o que foi validado e que mede o próprio erro às cegas é uma base sobre a qual se pode construir.
Próximos artigos da série: busca semântica e matching cliente–imóvel.